

Что, если вместо бесконечного «покрутил DSP — померял — опять покрутил» можно один раз измерить каждый динамик в машине, собрать виртуальную систему и дальше настраивать её дома? Крутить срезы, задержки, гейны и эквалайзеры, сразу видя, что получится после переноса настроек в настоящий процессор.
Именно так работает Resonalyze. Если измерения сняты правильно, а фильтры соответствуют вашему DSP, расчёт должен совпасть с повторным замером в той же точке микрофона — в пределах погрешности измерений.
Почему Resonalyze, если уже есть REW, Smaart и Open Sound Meter? Это прежде всего измерительные инструменты. Если грубо — продвинутые «градусники»: показывают, что происходит с системой, помогают найти проблему и проверить результат изменений. Возможности моделирования у них тоже есть, тот же REW умеет прогнозировать сложение пары измерений. Но Resonalyze делался как инструмент инженерного моделирования для сведения многополосных систем, с уклоном в автозвук. Здесь вы собираете всю систему из измерений отдельных динамиков, задаёте обработку каждого канала и оптимизируете их совместную работу ещё до переноса настроек в железо.
Теперь я добавил пространственное усреднение и закрыл весь цикл настройки: от первого замера до готовых кроссоверов, EQ, задержек и полярностей. Автоматика берёт на себя основную работу по подбору настроек. Всё бесплатно, с открытым исходным кодом и подробным руководством. Писал для своей машины, но немного увлёкся.
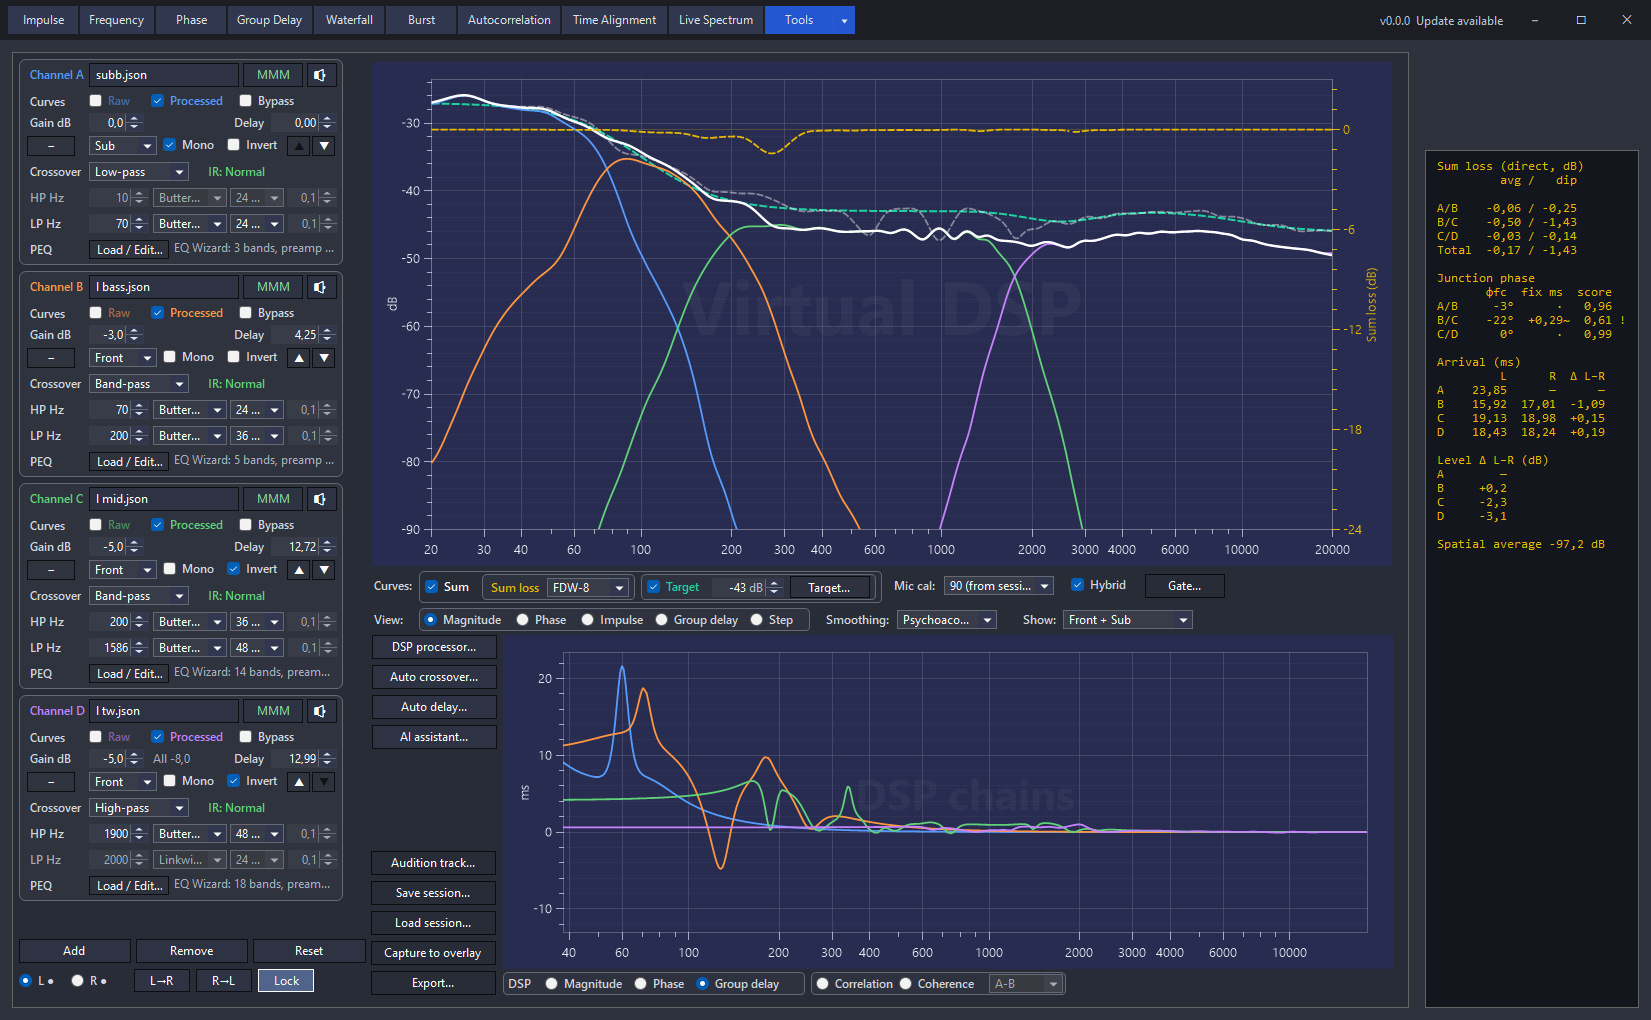
И вот почему это работает.
Поведение линейной системы можно описать одним массивом чисел — импульсной характеристикой, дальше ИХ. Измерив её для каждого динамика, вы получите слепок его работы в своей машине: с оформлением, резонансами и всеми переотражениями на пути к микрофону. Главное — сохранить временную привязку между замерами. Для этого микрофон и loopback записываются синхронно, одной звуковой картой.
Дальше программа переводит ИХ в комплексный спектр, применяет выбранную DSP-обработку и складывает каналы с учётом амплитуды и фазы. Звуковое давление в точке микрофона складывается линейно, поэтому можно заранее рассчитать, что он измерит после изменения настроек.
Микрофон при исходных замерах не двигаем, конфигурацию системы не меняем, динамики в нелинейный режим не загоняем. Искажения и компрессию модель не воспроизводит. Дальше можно перебирать десятки вариантов кроссоверов и EQ уже дома. В машину вернётесь с готовой настройкой для проверки.
К этому моменту я лично помог настроить примерно шесть автомобилей пользователей с американских форумов. В том числе монструозные системы с двумя сабами, центром и тылом, измеренные заводскими многомикрофонными системами.
У американских любителей SQ встречается великолепный подход: поставить в машину оборудование на десятки тысяч долларов, купить профессиональную звуковую карту, микрофонный массив, дорогой софт — и потом практически вслепую настроить всё это хозяйство. Зато такие машины помогли доработать алгоритмы далеко за пределами собственного корыта.
Теперь про пространственное усреднение.
Один микрофон измеряет одну точку. Сдвинули его на несколько сантиметров — часть пиков и провалов изменилась. На СЧ и ВЧ переотражения в салоне вообще превращают АЧХ в фарш. Можно старательно выправить его эквалайзером, а потом наклонить голову и получить совсем другую картину.
Для настройки тонального баланса лучше усреднить АЧХ вокруг головы. Можно двигать один микрофон под шумовой сигнал — метод MMM (move microphone metod), либо измерять несколько позиций одновременно массивом микрофонов. Программа умеет и то и другое.
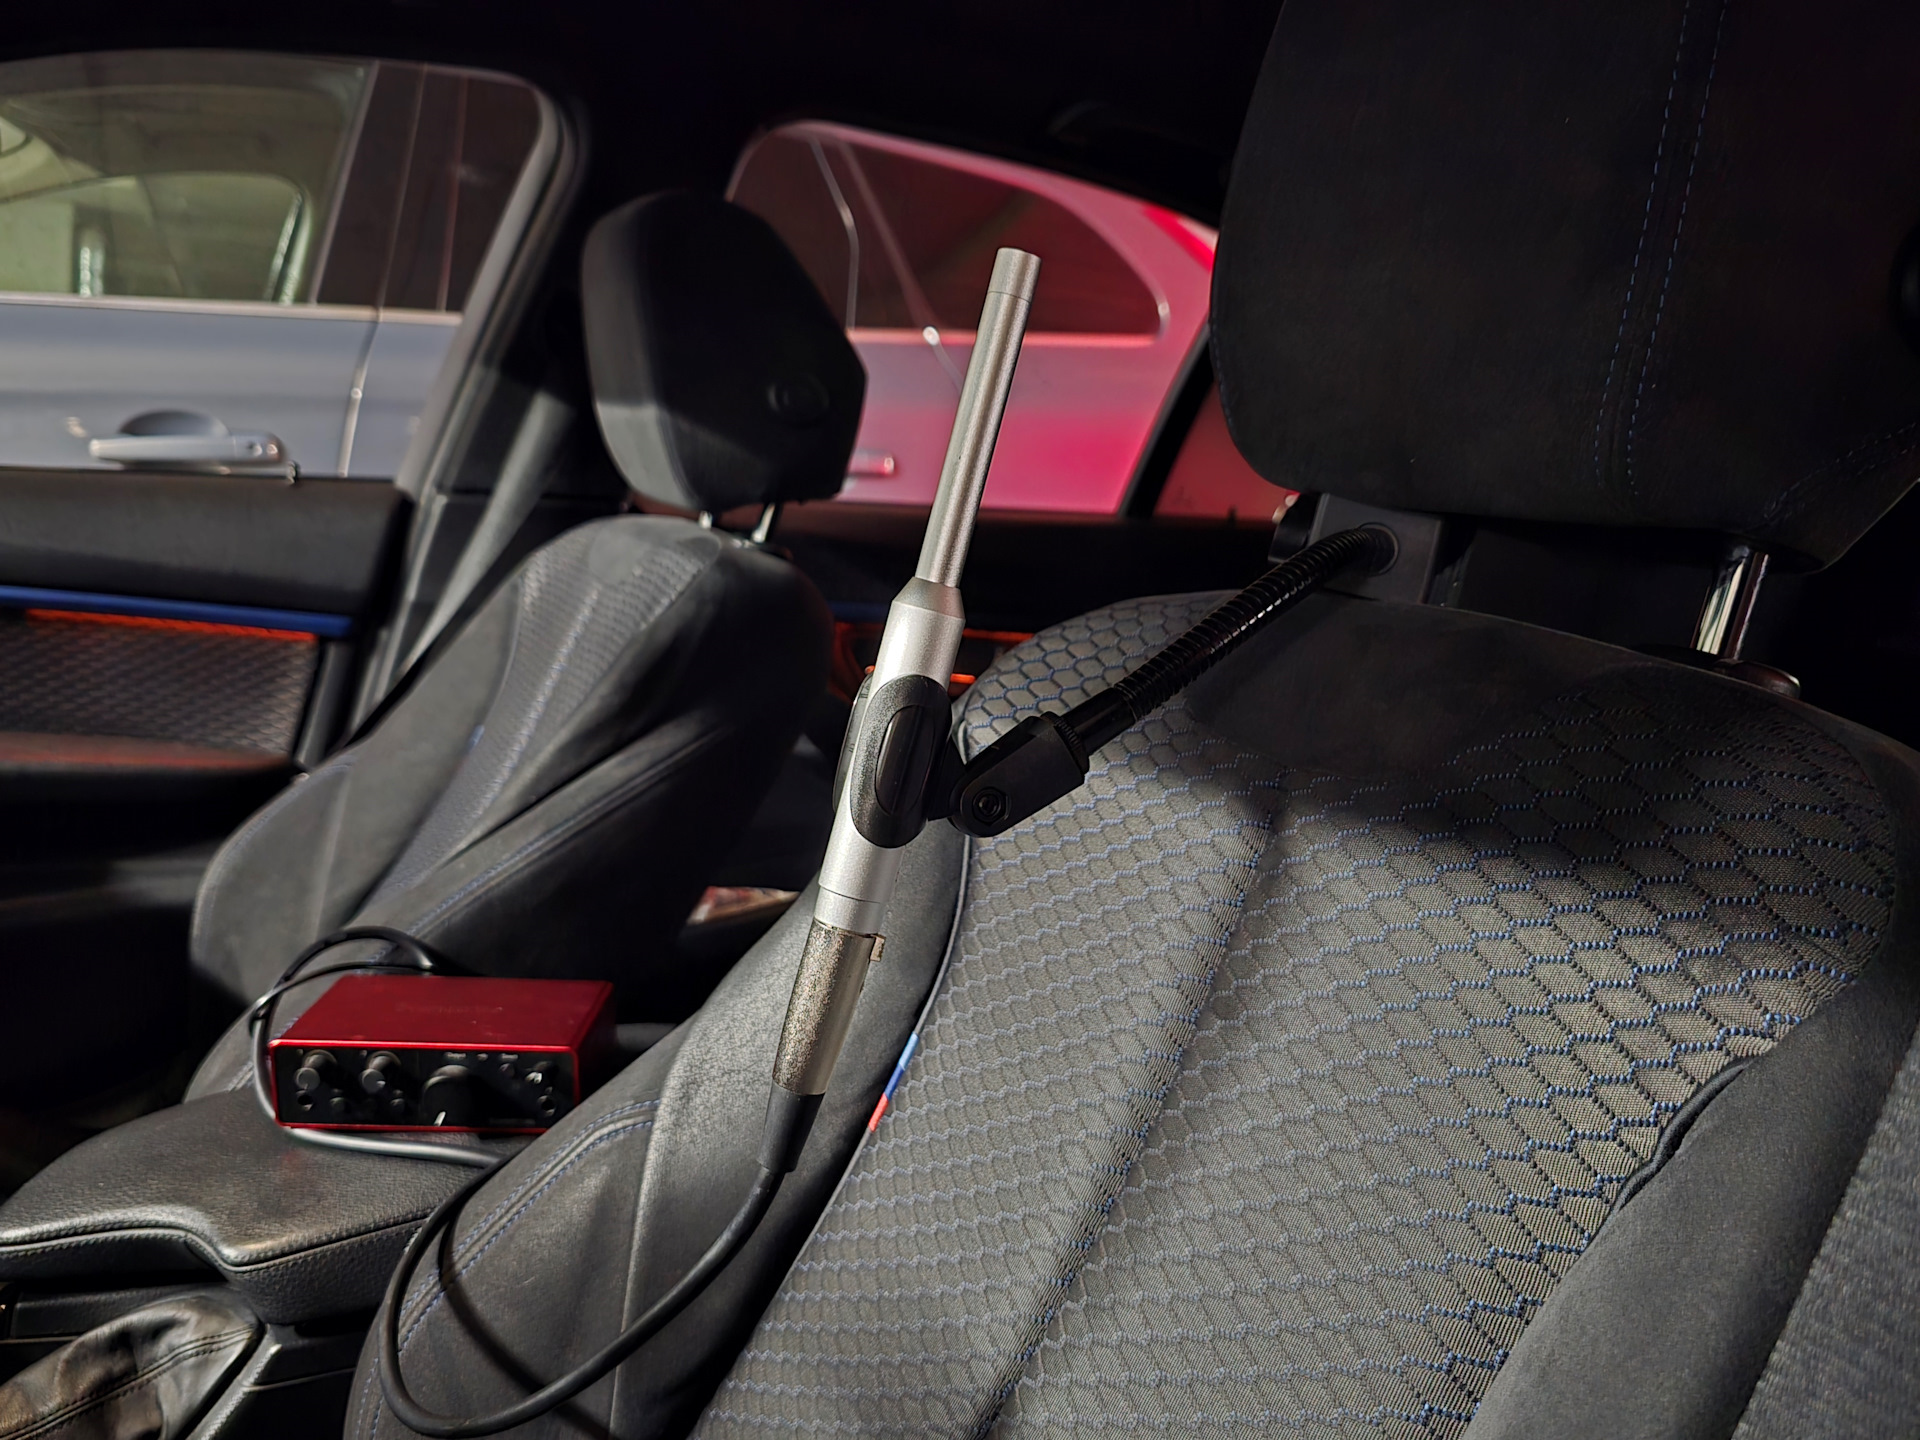
В первом случае сначала снимаем ИХ всех динамиков с неподвижным микрофоном. Затем каждый динамик отдельно измеряем методом MMM:
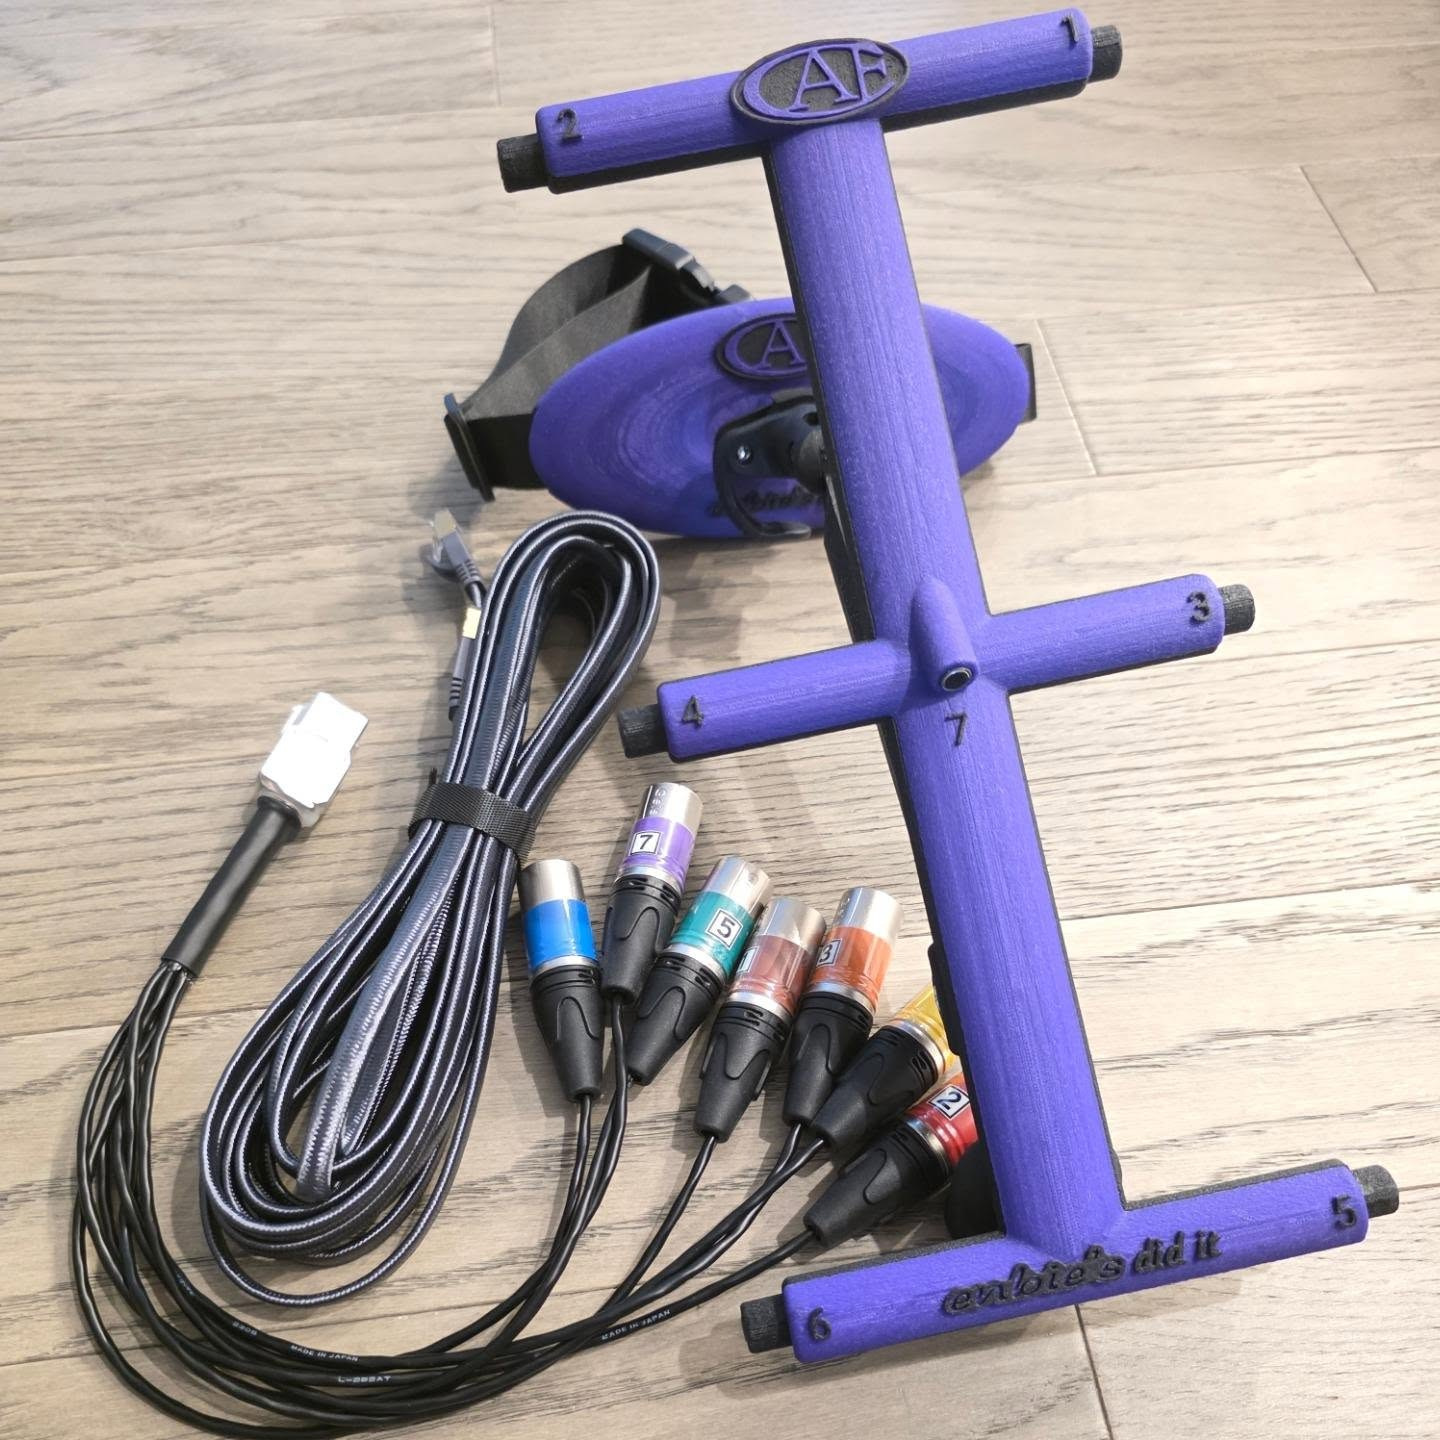
С массивом всё снимается одновременно, поэтому работы меньше. Но усреднение идёт по нескольким фиксированным точкам, и результат зависит от числа и расположения микрофонов. Одним подвижным микрофоном можно пройти всю нужную область:
Дальше включаем гибридный режим: АЧХ для эквализации берётся из пространственного среднего, а время и фаза — из замера опорного микрофона.
Пример одного и того же динамика: замер в одной точке и усреднение по массиву из семи микрофонов. Уже меньше хочется залить глубокие локальные провалы десятком децибел эквалайзера и отправить усилитель в клип:
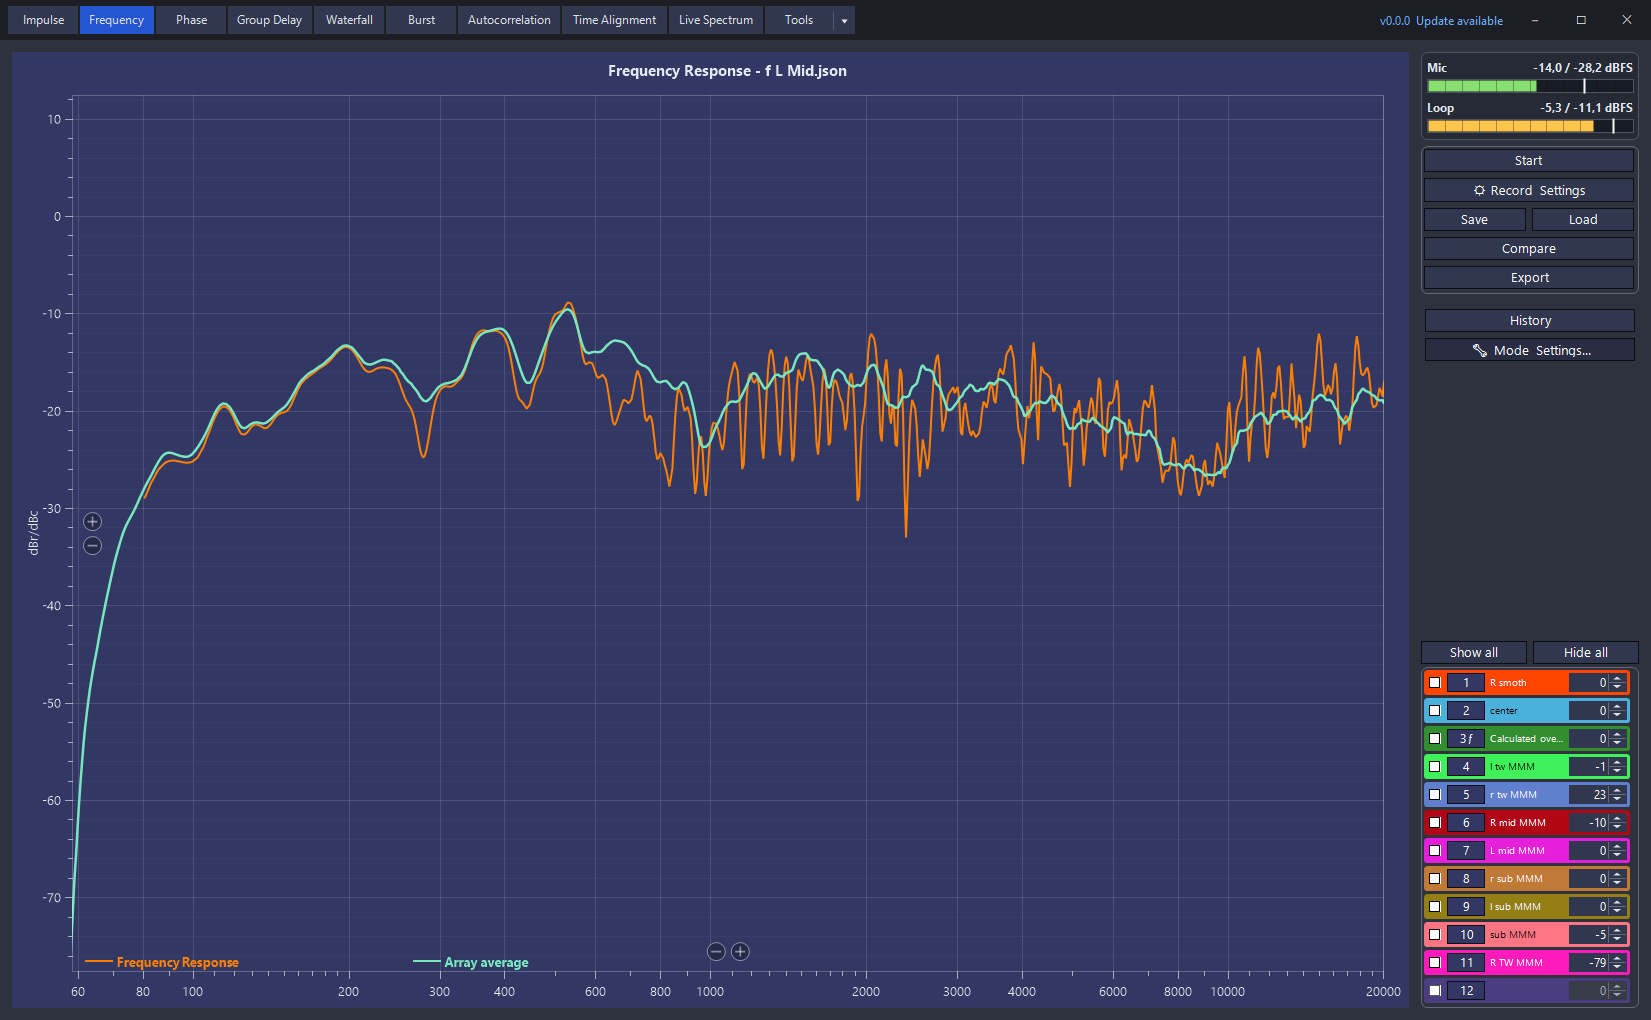
Фазовое согласование при этом остаётся привязано к опорной точке. Его устойчивость при движениях головы проверяем отдельно.
Теперь про согласование
Когда я впервые прогнал через программу настройки, с которыми ездил много лет, результат оказался неприятным. Задержки между левым и правым бортом были выставлены прилично, а между полосами — фазовый фарш, местами со сдвигом на несколько периодов. А я ведь считал, что разбираюсь в настройке…
Два динамика с хорошими индивидуальными АЧХ вместе могут частично гасить друг друга. На стыке они воспроизводят один и тот же сигнал, и всё зависит от относительной фазы. Усилители жрут электричество, динамики ходят, а часть звукового давления взаимно уничтожается.
Кроссоверы и EQ тоже крутят фазу. Поэтому выставить задержки по рулетке или даже точно измерить время прихода каждого динамика недостаточно. Нужно проверить, как полосы складываются после всей обработки.
Причём совместить фазу на самой частоте среза тоже мало. На 1 кГц лишняя миллисекунда задержки — полный оборот на 360°. Фазы совпали, но один динамик уже отстал на целый период. На соседних частотах совпадение разойдётся. И по одной точке вы эту ошибку вообще не увидите.
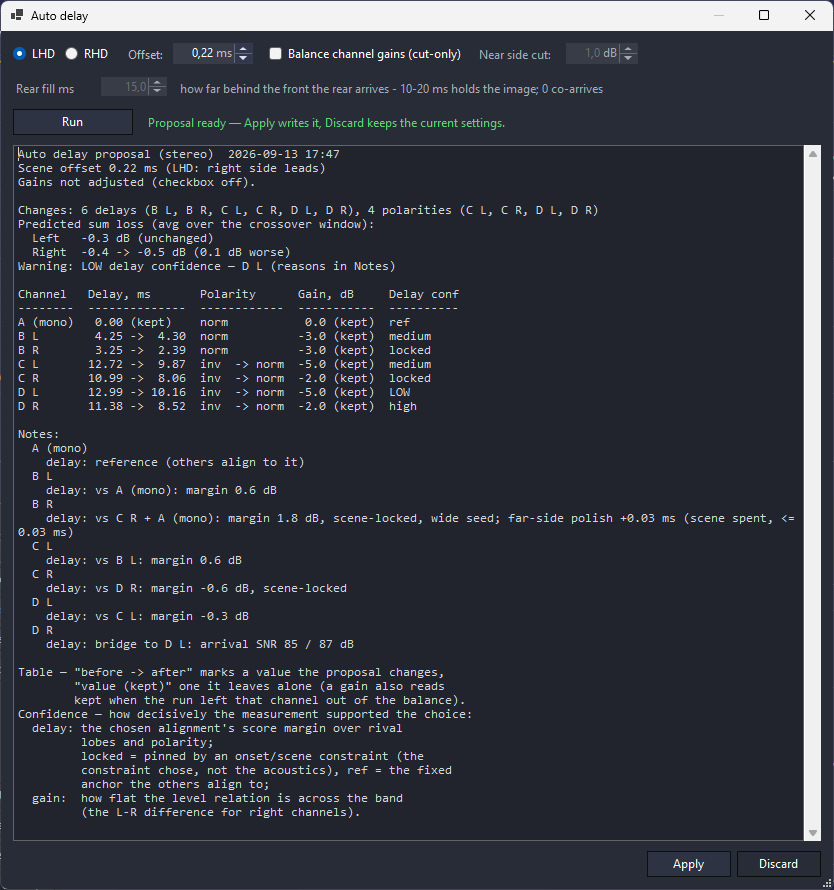
Чтобы упростить жизнь, в программе есть кнопка Auto delay, которая настроит задержку каждого динамика за вас. За ней скрывается несколько этапов. Сначала программа выделяет нужную полосу частот и анализирует огибающую ИХ, чтобы найти приход сигнала. Самый высокий пик не обязательно означает прямой звук: отражение или раскачавшийся резонанс салона могут оказаться громче.
Дальше используются корреляционные методы, в том числе GCC-PHAT — обобщённая взаимная корреляция с нормализацией взаимного спектра. Модуль взаимного спектра нормируется, чтобы громкие частоты не перетягивали оценку задержки на себя. Положение корреляционного пика уточняется между отсчётами: поиск субсемпловый, поэтому время прихода не округляется до целого семпла. Но доверие к такому уточнению зависит от качества данных — лишние цифры после запятой сами по себе точности не добавляют.
На НЧ отдельная головная боль. Огибающая растёт несколько миллисекунд, прямой звук сливается с отражениями, и крошечная впадина может превратить один широкий горб в два. Искать «первый пик» в такой ситуации — отличный способ получить несколько миллисекунд разницы там, где их быть не должно.
Поэтому для сравнения парных НЧ-каналов L/R используется энергетический порог: момент, к которому накопилось 10% энергии сигнала в анализируемом окне. Суммируются квадраты огибающей, поздний хвост ограничивается, слабые отсчёты отсекаются порогом по уровню. Накопленная энергия растёт монотонно, поэтому оценка меньше зависит от того, превратился очередной изгиб огибающей в отдельный пик или нет. Это опорная метка для сравнения двух сторон, а не универсальное время прихода любого динамика.
После выбора временных ориентиров идёт финальный поиск дробной задержки и полярности по комплексному сложению во всём диапазоне стыка. Уже с учётом настроенных кроссоверов и EQ. То есть алгоритму нужно и не промахнуться на целый период, и добиться минимальных потерь при совместной работе полос.
Результат видно по Sum Loss — потерям относительно идеального синфазного сложения при тех же уровнях каналов. Чем ближе к 0 дБ, тем меньше сигнала потеряно из-за рассогласования. Если задержки и полярность не позволяют нормально свести фазу во всей области стыка, можно добавить All-Pass фильтр. В программе они идут отдельными слотами эквалайзера.
Ну и для совсем уж психов есть FIR: можно загрузить готовые фильтры или собрать фазолинейные кроссоверы во встроенном конструкторе и проверить их в своей виртуальной системе. Для переноса в железо ваш процессор, разумеется, должен поддерживать пользовательские FIR.
Качество замеров тоже контролируется: свипы усредняются, когерентность показывает, каким частотам можно доверять. Автотюнер выдаёт отчёт с оценкой уверенности в предложенных задержках. Сомнительные решения лучше перепроверить:
Кроссоверы и EQ под целевую кривую тоже можно подобрать автоматически. Главное — закончить с ними до запуска автозадержек. И помнить про ограничения динамиков: по тихому свипу программа не узнает, на какой громкости ваша пищалка сделает пшик. Кстати, для защиты твитеров во время замеров есть два независимых механизма: ограничение полосы генерируемого свипа и поддержка защитного HPF. Это когда вы оставляете в своём DSP защитный фильтр на канале и указываете его в программе — она компенсирует его влияние на АЧХ и ФЧХ в пределах достоверности замера.
Что получается на выходе
Готовая настройка, которую можно сохранить проектом или выгрузить в PDF-шпаргалку для переноса в DSP. Программа учитывает частоту обработки процессора и его определение добротности Q. Да, одинаковые цифры у разных производителей могут задавать разные фильтры. Для HELIX есть выгрузка эквалайзеров в нативные файлы — чтобы не вбивать вручную.
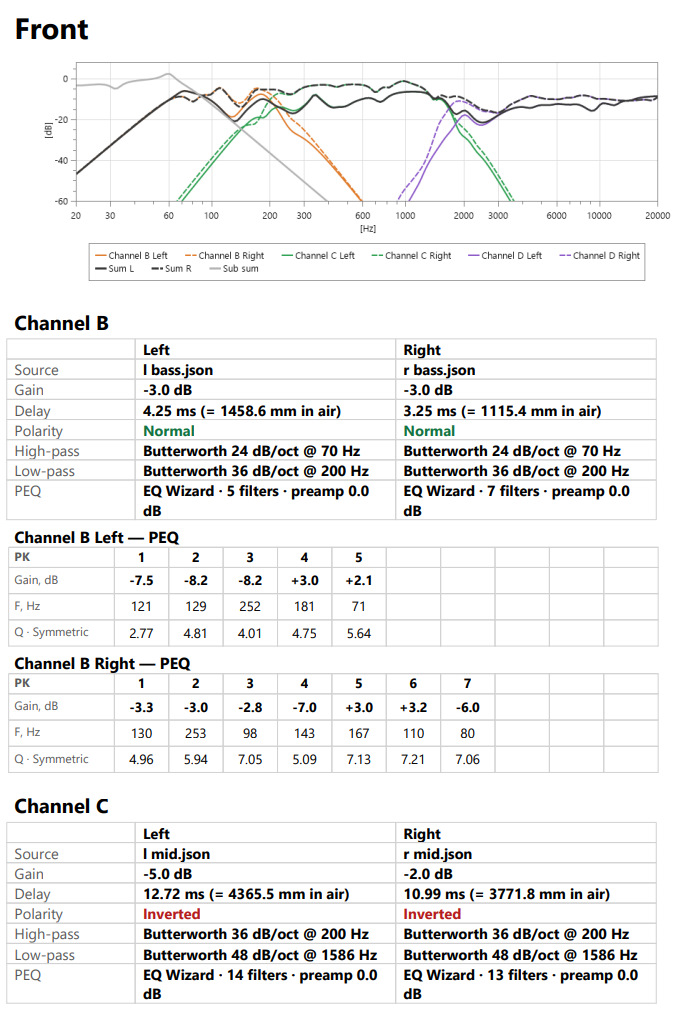
После переноса делаем контрольный замер. Если он сильно отличается от расчёта, ищем ошибку: перепутанный канал, полярность, другой фильтр или лишняя обработка в тракте. Проверяем систему на рабочей громкости, слушаем знакомую музыку и подгоняем баланс под себя.
У меня после исправления согласования сцена стала заметно устойчивее при движениях головы, появился панч, а бас локализовался спереди. Наконец-то долбанные сибилянты звучат естественно и больше не режут слух. Особенно радуют барабаны — теперь они буквально передо мной на капоте. Железо осталось прежним. Стоило сначала заставить имеющиеся динамики нормально работать вместе.
В общем, теперь можно самостоятельно настроить систему на профессиональном уровне. И вполне обойти студию, где умеют рисовать АЧХ, но про временное и фазовое согласование полос даже не слышали. Понадобятся Windows, аналоговый измерительный микрофон, звуковая карта с loopback и возможность подать сигнал в DSP. USB-микрофоны вроде UMIK не подойдут: микрофон и опорный сигнал должны записываться синхронно одной картой.
Подключения, порядок настройки и все важные нюансы разобраны в мануале. Переписывать его сюда не буду.
Ну и делитесь результатами. Особенно интересно, что обнаружится в настройках, которые до этого считались финальными)


Комментарии 118
Мануал на русском языке. Перевод местами корявый, замечания приветствуются.
drive.google.com/file/d/1…fEG5s_AK/view?usp=sharing
Интересная тема, надо как нибудь поигратьтся.
Вообще мне Smaart позволяет сделать всё что нужно, освоив его хорошо можно трёшку за пару часов настроить великолепно.
Я использую самодельный микрофон на WM61A, переделанный, с усилителем со следящей ООС, его потенциальные неравномерности АЧХ имеют тембровый характер на ВЧ и НЧ, там тебр можно и на слух подкрутить, а в самом информативном диапазоне он ровный, для фазового согласования вообще пофигу, так как измерения относительные.
Острые пики и провалы на СЧ и ВЧ вообще сильно не трогаю, пришёл к выводу что это портит звук, да и смыла в этом нет, достаточно сместить микрофон на пару сантиметров или опустить/поднять солнцезащитный козырёк и прежнюю АЧХ будет не узнать.
По хорошему нужно перед выбором частоты среза измерить искажения компонентов в определённом диапазоне частот.
Потом включаю в процессоре "моно режим" (чтобы стереоэффекты не мешали) и кропотливо на слух кручу уровни и задержки в узком диапазоне, довожу "центр" до идеала.
Центр всегда настраиваю перед собой.
При некотором расположении СЧ и ВЧ сцену настроить идеально невозможно, это бывает когда из-за расположения левых СЧ и ВЧ они имеют малую относительную разницу времени прихода к левому и правому уху.
Я так понимаю, в автозвуке нет решений типа DBX PA, когда и хост, и измерения, все в одной коробке
Есть проприетарные алгоритмы авто настроки у конкретных производителей для своего железа. Но они тупенькие — типично просто подогнать динамики по пику ИХ.
Странно, что алгоритмы в автозвуке "тупенькие"
Хотя в мире домашнего аудио это стандарт высококачественного звука
Вы кажется подверглись влиянию жесточайшего маркетинга. Где именно это стандарт ВЫСОКОКАЧЕСТВЕННОГО звука.
Все RoomEQ примитивные
Да нет. Просто вы невежественный.
Очень интересный проект получился, надо будет поэкспериментировать с ним)))
Еще поигрался с программой и появились доп. вопросы:
1. Как система рассчитывает рекомендуемые кроссоверы? Какие данные для этого используются? Всегда ли lpf нижней полосы приходится на ту же частоту, что и hpf верхней (в моих экспериментах всегда получалось именно так)? Если так, то почему именно так?
У меня например в текущей системе частоты срезов сч и вч значительно разнесены друг от друга и это неплохо работает, поскольку сч забирается довольно высоко с хорошей отдачей, в тоже время и вч на своем нижнем краю имеет сильный подъем (вероятно из-за специфики расположения). Разнесение частот среза при этом позволяет использовать более низкие порядки и меньше эквализации в зоне стыковки полос (по крайней мере при настройке через rew).
2. Программа как-то принимает во внимание индивидуальные целевые кривые для каждого динамика? Сложилось впечатление, что всё, что происходит ниже частоты раздела и по уровню хотя бы на 1дб тише основной целевой кривой — программу не волнует, ни на этапе выбора кроссоверов, ни на этапе эквализации.
Такой подход был выбран намеренно? Просто если так стыковать мою систему, у сч и твиттера будет огромная зона совместного излучения вокруг зоны кроссовера, что вероятно будет негативно влиять на звук. При этом на стыке мидбаса и сч наоборот, со стороны сч не получится обеспечить соответствующий акустический спад ниже точки кроссовера (мне предлагается 200гц ниже которых у сч просто практически нет отдачи).
Через пару недель доберусь до оборудования и попробую настроить вашей программой и послушать, интересно конечно, как сработает методика в жизни.
Спасибо за вопросы, отвечу по обоим пунктам.
1. Кроссоверы. Auto Crossover работает по сглаженным АЧХ каналов и данным THD, если они есть. Сначала он находит рабочую полосу каждого динамика: край там, где кривая падает на 8 дБ. Потом определяет тип динамика и оценивает Fs твитера: на Fs нужно не меньше 22 дБ ослабления. Дальше перебираются частота, тип, крутизна и уровни, результат оценивается по ровности суммы «измеренный отклик × фильтр». К ровности добавляются штрафы: за широкое перекрытие, за отход от 24 дБ/окт, за стык в 2–4 кГц. Отдельный штраф тянет стык мидбас/СЧ ниже примерно 250 Гц, отсюда и ваши 200 Гц. Лучшие варианты проверяются на импульсах: сколько потерь останется после подбора задержки.
ФНЧ и ФВЧ на одной частоте — это упрощение модели: один параметр на стык, как в классическом LR. Утверждения «так лучше» за этим нет. Ваш случай, где СЧ играет высоко, а у твитера подъём снизу, как раз тот, где разнесённые срезы оправданы. Визард их не ищет, но руками в Virtual DSP можно поставить что угодно, и Sum Loss с фазой стыка это корректно читают. AI-ассистент тоже умеет сравнить разнесённый вариант с совпадающим.
2. Целевые кривые. Индивидуальных акустических целей для каналов нет, цель одна на систему. При передаче канала в EQ Wizard с DSP окно автоподбора ограничено срезами канала, поэтому за срезом он действительно не эквализирует. Если передать канал в режиме raw, без кроссовера, окно задаётся свободно, и можно выровнять любой участок, в том числе зону ниже будущего среза. Визард подбора кроссовера естественный спад динамика учитывает, но оценивает ровность суммы после сведения задержкой, а симметрию акустических спадов не проверяет. Если СЧ ниже 200 Гц не играет, проверьте тип канала и нижнюю границу в диалоге или задайте этот стык руками.
Будет интересно узнать, как это покажет себя на железе)
А можно ли вставить набор микрофонов в микшер и подать его выход на вход обычной звуковой карты, чтобы ещё и на дорогущую мноканальную карту не тратиться? Будет смикшированный сигнал чем-то отличаться от программного усреднения по массиву?
Нет, так не получится. Тут все по возрослому — для каждого микрофона стоится своя собственная импульсная характеристика. Оценивается confidence. И выполняется честное энергетическое взвешивание для усреднения.
Но многомикрофонные массывы нужны больше студиям автозвука для повторяемости.
Дополнительный замер методом подвижного микрофона будет не хуже, просто требует твердой руки — описывать одну и туже пространственную фигуру для каждого динамика. Как для настройки своего авто это иделальный способ эквализировать АЧХ.
В пейперах, что я читал, правильно выполненный метод подвижного микрофона сопоставим или даже лучше 16 пространственно разнесенных микрофонов.
Ну а если просто подсунуть программе сигнал, просуммированный микшером, вместо сигнала от подвижного микрофона?
Там многократно размажет фронт импульсной характеристика (приход у каждого микрофона свой) — программа не сможет выполнить нормальное сведени каналов по времени.
Я говорю только про тоналку, а не про сведение каналов. От МММ ведь берётся только АЧХ и не используется ИХ, или я неверно понял?
А, тут есть два пути. Если микрофонный массив честный, то он снимет пространственное усреднение АЧХ прямо во время основного замера и сохранит его внутри файла замера.
МММ же это дополнительный замер который в режиме Live Spectrum, результат которого можно подключить в карточки каналов.
Если попытаться хакнуть систему и в первом варианте замешать массив микрофонов в один, то они начнут конфликтовать между собой — какой-то даст сигнал в плюсовой фазе, какой-то в минусовой. В итоге получится совершенно не пространственное энергетическое усреднение, а куча противофазных помех.
Да, это я понял. Так можно ли смикшировать несколько закреплённых микрофонов в дополнительный замер в режиме Live Spectrum, представив это программе как МММ, просто потому что это удобнее и быстрее, чем размахивать микрофоном?
Эээ, ну теоритически можно. Но это будет хуже чем размахивать микрофоном и хуже чем честный массив…
Хотелось бы какой-то разбор логики работы софта и последовательности настройки, по которой вы предлагаете работать. Я поигрался часок с импортированными из rew замерами и вообще не могу понять, как ваш софт работает с гейнами, учитывает заданную целевую кривую, подбирает частоты срезов.
И есть ощущение что импорт из другой программы вообще нормально не понимается софтом, банально некуда калибровочный файл прикрепить.
Справедливое замечание. Импорт из REW добавлег немного сбоку. Для нативной работы нужно замерить машину через саму программу. Вы не смотрели мануал? github.com/DIMOSUS/Resonalyze/blob/main/MANUAL.md
Там я подробно провожу по необходимой последовательности шагов.
Сам софт полу автоматический. Выполнить настройку можно полностью в ручную, а можно пользоваться инструментами автоматизации (автокроссовер, автоэквализация, автосведение задержек). Гейны под целевую кривую нужно подобрать самостоятельно ориентируясь на то, что бы меньше потом добивать эквалайзером (не стал автоматизировать то, в чем не уверен)
Мануал смотрел, но то что я увидел после импорта из рев несколько порвало шаблон. Попробую на досуге прогнать целиком из софта замеры, к сожалению под рукой сейчас железа нет.
Честно не обкатывал на замерах из REW. Импорт из него я использовал больше для валидации что мой софт проводит замеры не хуже. При импотре через текстовый файл из REW может быть потеряна временная привязка просто из-за особенностей самого REW.
Можете поэкспеременирвоать на моей машине что бы понять закрывает ли программа ваши потребности:
github.com/DIMOSUS/Resona…ze-test-data/tree/main/v5
Еще вопрос, вы в мануале предлагаете после замеров импульса померить сразу же ачх через MMM и розовый шум, но кажется софт не умеет ограничивать частоты розового шума (чтобы защитить твиттеры и сч), а замер также предлагается делать без hpf.
Как тогда мерить?
Был не прав, я уже сделал учет HPF при MMM замерах. То есть оставляете его в вашем DSP для твиттеров, указываете в основных настройках программы и режим MMM учтет наличие фильтра. Поправлю мануал.
По описанию — очкруто, задонатил чуток автору. К следующим соревнованиям попробую настройку при помощи этой тулзы.
А русский язык есть?
Нет, для одиночки в хобби проекте поддерживать мультиязычнуй интерфейс проблематично, поэтому выбрал один универсальный язык.
Лайк и подписка автору!
В посте тщательно скрыта и перевернута с ног на голову концепция ручной профессиональной настройки аудиосистемы автомобиля. Но если цель вложить народу мысль что настройка — это всего лишь "покрутил-послушал", то пусть будет так.
Можно подробней? Мой главный посыл был: "Нет смысла делать множество повторных замеров в авто. Достаточно замерить один раз для точной виртуальной симуляции (в пределах линейной работы динамиков)".
Как хорошо, но скоро снесут тут это к сожалению
О как. Думал ни чего не нарушаю…
Может и нет
Ну, удалят — пойду помогать другим сообществам. Не дравом единым живет автозвук…
andrew177
Как хорошо, но скоро снесут тут это к сожалению
С чего вдруг?
С ума сойти, вот это колоссальный труд! Обязательно попробую в самое ближайшее время!
добрый день! а каждый динамик нужно измерять отдельно в полную полосу?
Да, в полную полосу, без эквалайзера, без задержек и фильтров, на одинаковом гейне. Единственное исключение — стоит оставить хай пасс кроссовер для твиттеров, или нежных СЧ. Но обязательно указать его параметры в настройках программы, там где задается диапазон и время свиптона. Тогда программа сделает его частотный и фазовый вычет.
Привет. Подскажите, знающие, какую внешнюю звуковую карту можно купить для ноута, чтоб можно было настраивать?
Я использую Focusrite solo gen 4. У него встроенный loopback и не нужно заморачиваться с отдельным кабелем. И еще отличная работа с Asio.
Но подойдут и простые звуковые карты. Главное что бы они были стерео и можно было закольцевать выход с одним из входов.
Благодарю! Буду разбираться
Dima111-55
Привет. Подскажите, знающие, какую внешнюю звуковую карту можно купить для ноута, чтоб можно было настраивать?
У меня Behringer U-Phoria UM2, самый недорогой вариант, но loopback придётся делать проводом.
Год назад шел по похожему пути, только с софтом попроще, по гайду raw-cat. Купил себе и UMIK, и аналоговый микрофон с USB звуковой, чтобы задержки измерять, но не хватило времени, сил и терпения довести дело до ума. Да и в машине не очень удобно пол дня сидеть с ноутом, играться. Для новичка там много неочевидных нюансов и я решил, что проще заплатить бабки профессионалу, чем самому тратить кучу времени, чтобы довести систему до идеала. Одно дело как-то базово настроить и совсем другое выжать максимум из системы. Но, возможно, будет время, попробую по вашему гайду. Спасибо за труды!
эх, осталось собрать процессорную систему…
Немного не в тему, но посоветуйте микрофон для замеров.
wikisound.store/product/s…did_ref_measurement_micro
maxwagen
Немного не в тему, но посоветуйте микрофон для замеров.
ECM8000
Когдато был топ за свои деньги. Но… Cross Spectrum Labs отказалась делать индивидуальные калибровки ECM8000 из-за их тотального брака.
задержку по началу IR динамика с оключенным LP, согласование в полосе совместной работы по наклону Phase response, локализацию добиваем на слух задержкой и уровнем
Когда-то с этого и начинал. Но нет — слишком поверхностно и не раскроет весь потенциал системы.
для начала норм
эквализация после всего, по 9 точкам как в дирак лайв
Эквализация после развалит же все тонкое фазовое согласование стыков. Эквалайзер меняет минимальную фазу системы.
сдуру можно и "зуй" сломать
лучше выбирайте кросспойнт
Если пики IR смотреть без LP, то не будет учтена значительная Group Deray, которую неизбежно добавляет кроссовер (ну, если он не фазолинейный FIR). И вот уже промахнулись на пару периодов на стыке и панч пропал.
А почему пики? Сам же пишешь — "поэтому для сравнения парных НЧ-каналов L/R используется энергетический порог: момент, к которому накопилось 10% энергии сигнала в анализируемом окне."
тоесть не пики а начала
Сори, теперь вижу что у вас "Начало IR".
Однако начало — вещь хрупкая, особенно на НЧ. В программе для оценки времени прихода НЧ испльзуется анализ огибающей IR после всей обработки (EQ и кроссоверов). Считаем что звук пришел когда огибающая переходит порог в 10% (выбиралось по одной научной статье). Но это только пристрелочное сведение. А после программа начтет уточняющее сведение полос по кросскореляции по отбеленному спектру методом GCC-PATH (с линеаризированным АЧХ) и выберет тот период, который даст максимальную кореляцию. При необходимости инвертирует один из каналов, если это дает лучшее согласование. На ВЧ тоже в два этапа, но на первом используется первый пик огибающей IR (с уточнением до сотых доле семпла). Фактически движок автосведения программы тоже целится в совпадение наклонов фазы, но чистит её перед этим (ровняет минимально фазовую часть). Это повышает надежность обнаружения правильного лепестка корреляции на зашумленном переотражениями сигнале.
am-studio
А почему пики? Сам же пишешь — "поэтому для сравнения парных НЧ-каналов L/R используется энергетический порог: момент, к которому накопилось 10% энергии сигнала в анализируемом окне."
тоесть не пики а начала
Что бы не быть голословным вот сравнение IR трех полос с и без их кроссоверов. Видно насколько сильно кроссоверы задерживают прохождение сигнала.
По идее начало импульса не должно смещаться в зависимости от наличия или отсутствия фильтра. Разве что конкретный DSP добавляет внутреннюю задержку при увеличении объёма обработки.
Законы физики этого не позволяют. Не я это придумал) Любая фильтрация требует задержки сигнала. Даже FIR (просто на них задержку можно сделать линейной по всему диапазону).
FIR сам по себе вносит задержку в зависимости от количества тапов. Ну например при моделировании в REW начало импульса не смещается в зависимости от IIR фильтра. Меняется форма и может сдвигаться пик.
Признаю, я написал неточно. Начало импульса может остаться на месте, но основная его энергия после фильтра уже приходит позже.
В случае lowpass'ов да, т.к. отсекается энергия ВЧ. Однако идеальное суммирование полос в том же REW всё равно получается без сдвига импульсов по времени относительно друг друга.
Не совсем. HP тоже задерживает сигнал. У нормальной согласованной пары HP/LP одного порядка на частоте раздела group delay одинаковый, поэтому отдельный сдвиг одной полосы относительно другой не нужен.
То, что у lowpass импульс выглядит сильнее растянутым вправо, ещё не значит, что именно он «пришёл позже». Это просто другая форма импульсного отклика из-за другого спектра.
Без сдвига по времени можно суммировать и разные порядки, в некоторых случаях даже лучше получается, чем с парными.
Да, так как акустический спад ачх самого динамика также вносит вклад. Более корректно гововить про акустический кроссовер (сумму электрического и собственного спада динамика). Если твитер имеет свой спад в 6 дБ на октаву, а СЧ на частоте раздела еще ровный, то ассиметричный кроссовер, скажем 24 и18 более чем правильное решение.
Я имел в виду электрическое суммирование. С учётом динамиков всё несколько сложнее уже :)
imp070
Без сдвига по времени можно суммировать и разные порядки, в некоторых случаях даже лучше получается, чем с парными.
Собственно для этого и нужна эта программа — в пару кликов пробовать разные варианты и видеть точную симуляцию. И все в любимом кресле с котом на коленях, а не скручившись в авто под визги периодического розового шума)
dimosus
Не совсем. HP тоже задерживает сигнал. У нормальной согласованной пары HP/LP одного порядка на частоте раздела group delay одинаковый, поэтому отдельный сдвиг одной полосы относительно другой не нужен.
То, что у lowpass импульс выглядит сильнее растянутым вправо, ещё не значит, что именно он «пришёл позже». Это просто другая форма импульсного отклика из-за другого спектра.
вот, сам же ответил
dimosus
Что бы не быть голословным вот сравнение IR трех полос с и без их кроссоверов. Видно насколько сильно кроссоверы задерживают прохождение сигнала.
где видно и на сколько?
Для предметного спора с профи старой закалки сделал более чистое сравнение. Один подсидельный мидбас без кроссоверов, HP, LP и в Band-Pass.
Время прихода по окну мощности в 10% (когда ИХ отдала 10% всей своей мощности):
Off: 8,76 мс
HP: 10.47 мс
LP: 13.62 мс
BP: 15.77 мс
ну ты еще бы 48 или 96 дБ применил
Правильный метод должен работать в любых условиях) Я оттачивал алгоритмы в заведомо сложной и не удачной иснталяции (все динамики на штатных местах). Было много сложностей с ложными срабатываниями, но получилось их перебороть разными ухищрениями. Как раз что бы бороться с приходами на НЧ и ввел окно по мощности.
Сейчас пытаюсь научиться понимать свою систему по Step Pesponce.
Может подскажете — вот такой (белая линия сумма каналов), если не доступны FIR, можно назвать оптимальным? Ни какого сарказма. Просто уперся в потолок понимания и не знаю у кого спрашивать такие тонкости)
Я как то давно, пытался разобраться с алгоритмами DiracLive. Но там FIR.
По поводу авто настройки, может прибегнуть к хитрости и часть параметров все таки в ручную вводить?
Дабы была какая то опорная точка.
Программа не навязывает автоматизацию. Все можно настроить только руками (кроссоверы, задержки, эквалайзеры, фазовращатели). Для оценки результата есть все базовые представления и даже чуть больше (честная ачх с учетом фазового сложения, оценка потери на стыказ от промаха с фазой, групповая задержка и фаза с возможностью удобно смотреть только ранний приход через FDW, ИХ, степ респонс, кореляция каналов на стыках, когерентность прихода звука на стыках и еще по мелочи). Так же есть возможность прогнать любой свой трек через виртуалтную симуляцию салона и в наушниках оценить как звучит авто (эквализация, положение сцены). Эта функция помогла мне понять что раньше эквалайзер я крутил не правильно…
заинтриговал, надо попробовать
dimosus
Правильный метод должен работать в любых условиях) Я оттачивал алгоритмы в заведомо сложной и не удачной иснталяции (все динамики на штатных местах). Было много сложностей с ложными срабатываниями, но получилось их перебороть разными ухищрениями. Как раз что бы бороться с приходами на НЧ и ввел окно по мощности.
Сейчас пытаюсь научиться понимать свою систему по Step Pesponce.
Может подскажете — вот такой (белая линия сумма каналов), если не доступны FIR, можно назвать оптимальным? Ни какого сарказма. Просто уперся в потолок понимания и не знаю у кого спрашивать такие тонкости)
Мне представляется, что начала импульсов должны быть из одной точки. А тут саб и вуфер опережают СЧ и ВЧ. Сравнивали с моделью системы в том же REW?
Перенес свои измерения, кроссоверы и эквализацию в REW. Прогноз суммы саба и мидбаса совпал один в один — максимум сложение достигается там же, где и в моей программе (и с тем же степ респонсом, что на моем скрине выше)
imp070
Мне представляется, что начала импульсов должны быть из одной точки. А тут саб и вуфер опережают СЧ и ВЧ. Сравнивали с моделью системы в том же REW?
А вот степ респонс этого же эксперемента в REW. Видно что сумма по форме совпадает с моей программой один в один. Просто REW по умолчанию начинает интегрировать ИХ для получения степ респонса в сильно отрицательном времени (у меня он поставил окно начиная от -37 мс). По этому единого "начала степ респонса" вообще не существует — он зависит от окна анализа, которое мы сами задаем.
Я имел в виду немного другое — "нарисовать" в REW аналогичную схему кроссоверов с room curve, если она была, и посмотреть как будут расположены импульсы полос и как будет выглядеть step response.
Сделал такой эксперемент. Взял идеальные импульсы и собрал в REW только кроссоверы, без акустики и салона. Получилось то же самое: чтобы саб и мидбас нормально сложились по фазе, мидбас пришлось сдвинуть примерно на 3 мс вперёд. На step response это тоже хорошо видно.
Так что само требование, чтобы «начала импульсов» всех полос совпадали, не работает — одни только кроссоверы уже разводят их во времени.
Наверное потому, что кроссоверы непарные и поэтому неоптимально суммируются. При хорошем суммировании задержки не нужны.
Ответил ниже — один из них был байпас. Если ставить ему только HP, то получается без задержек.
imp070
Я имел в виду немного другое — "нарисовать" в REW аналогичную схему кроссоверов с room curve, если она была, и посмотреть как будут расположены импульсы полос и как будет выглядеть step response.
Еще уточнение. Для мидбаса заменил байпасс кроссовер на хай пасс. И вот тогда сдвиг по времени одного из каналов не понадобился и начала их степ респонсов практически совпали.
То есть для двух полосной системы действительно можно говорить что при идеально ровной АЧХ и ФЧХ динамиков подгонять их можно по началу степ респонса.
am-studio
ну ты еще бы 48 или 96 дБ применил
Andy Wehmeyer, если вам это имя о чём-то говорит, рекомендует всюду LR24.
но не BW36
Подсидельные мидбасы. Если их не резать круто, то они у меня загадят своей кучей переотражений часть диапазона где уже и так хорошо работают СЧ.
200 LR24 + эквализатор
Вот все тоже самое надо сделать, только для безпроцессорной системы.
VituixCAD :)
Тут для начала нужно перечитать труды автора несколько раз, потом это осмыслить, переспать не одну ночь с этой мыслью… скачать, установить, разобраться с софтом… Короче, ближе к следующему лету задам вопросы)))))
Реально новичку разобраться? Сами за какое время разобрались?
Сначала учил dsp в универе, потом еще года 3, пока писал эту программу. Но, на самом деле, если скинуть ссылку на мануал в GPT и попросить провести через всю настррйку — каких-то глубоких знаний не нужно.
А как Вы удаленно настраиваете?
Можно же подключится к пк который сопряжен с процессором и настраивать…
sergeibus
А как Вы удаленно настраиваете?
Я не занимаюсь удаленной настройкой — хлопотно это. Просто подсказываю людям, если они уперлись или что-то не поняли.
Технически, если снять ИХ каждого динамика, то выполнить настроку можно хоть из Австралии)
sergeibus
А как Вы удаленно настраиваете?
Еще в программе есть встроенный мост для ИИ ассистентов. Можно выгнать дамп вашей системы с кучей отладочной информации (отнють не только АЧХ) скопировать его в тот же ChatGPT и попросить помощи. Бот будет генерировать блоки инструкций которые нужно тоже копировать и вставлять в программу. Такими нехитрыми манипуляциями бот может полностью настроить систему за вас. Вы будет в роли биологического интерфейса между машиной и машиной)
Ну все, настройщики больше не нужны. Только железо и ИИ. Ну и владелец, который будет ctrl-c + ctrl-v делать )
dimosus
Еще в программе есть встроенный мост для ИИ ассистентов. Можно выгнать дамп вашей системы с кучей отладочной информации (отнють не только АЧХ) скопировать его в тот же ChatGPT и попросить помощи. Бот будет генерировать блоки инструкций которые нужно тоже копировать и вставлять в программу. Такими нехитрыми манипуляциями бот может полностью настроить систему за вас. Вы будет в роли биологического интерфейса между машиной и машиной)
спешу вас огорчить, уже не нужно )
Зарубежной аудитории зашло. Мне писали что часами общались таким образом с ботом и он реально помог найти людям нестандартные конфигурации, которые зазвучали лучше (в частности Бессель на стыке двух сабов).
это был сарказм про 28 августа )
dimosus
Еще в программе есть встроенный мост для ИИ ассистентов. Можно выгнать дамп вашей системы с кучей отладочной информации (отнють не только АЧХ) скопировать его в тот же ChatGPT и попросить помощи. Бот будет генерировать блоки инструкций которые нужно тоже копировать и вставлять в программу. Такими нехитрыми манипуляциями бот может полностью настроить систему за вас. Вы будет в роли биологического интерфейса между машиной и машиной)
И вероятнее всего в конечном итоге получится ерунда
Чат бот запускает внутренние иструменты программы. Он не выдумывает задержки или частоты сам. Так что ошибиться ему проблематично)
Я о всем методе в целом. Отсутствие контроля процесса ушами приведет к бестолковой трате времени за ноутбуком. Про замеры без человека на водительском сиденье я вообще молчу.
Для контроля ушами в программе как раз есть аудирование: можно прогнать любой трек через измеренную систему со всей текущей обработкой и послушать результат. Центр сцены у меня, например, в наушниках получается там же, где потом и в машине.
А вот человек на водительском во время измерений, на мой взгляд, скорее мешает. Он сам становится частью акустической системы: голова, плечи, положение тела вносят отражения и поглощение, причём плохо воспроизводимые от замера к замеру. Мне нужна повторяемая характеристика самой системы в фиксированной точке. А влияние головы и ушей уже происходит тогда, когда человек эту систему слушает.
Человек является частью системы и его присутствие влияет на замер, как и на сам звук. Но я буду мерить без него и вносить корректировки) я понял.
Кстати держу в курсе. То как будет играть музыка при условии использования звуковой карты как источника, и то как она будет играть от повседневного источника-разные вещи.
Вы уже, по-моему, начали спорить не с программой, а с тем, что сами про неё придумали :)
Человек на сиденье действительно влияет на поле. Именно поэтому для повторяемого базового замера мне он там не нужен. Малейшее движение тела или микрофона во время sweep уже портит импульсную характеристику, потому что система перестаёт быть стационарной во времени и настроить временное сведение достоверно уже нельзя. Могу допустить наличие человека во время замера подвижным микрофоном, там не нужна точная временная привязка. Но если нужно измерять именно влияние головы и ушей — это уже бинауральный замер, с честной неподвижной dummy head. Harman, например, салон так и исследует.
С EQ та же история: никто не вылизывает каждый зуб до ±0.5 дБ. Для этого есть пространственное усреднение (массивом или подвижным микрофоном) и ограничения на то, что вообще имеет смысл корректировать. В частности ограничения на максимальны Q и корекцию узких провалов. Target — это тональный баланс, а не соревнование за красивый график.
Скрин с кроссоверами — это результат конкретной демонстрационной сессии, а не таблица «ставьте всем 200/698 Гц». Автокроссовер работает от измеренных полос конкретных динамиков и потом проверяет их совместную работу. Оценивать эти цифры без самих исходных измерений — ну такое.
Про использование звуковой карты: ничто не мешает отдельно снять передаточную характеристику тракта от ГУ до DSP тем же REW и при необходимости скорректировать её. Причём если эта коррекция стоит перед разделением на полосы или одинаково применяется ко всем каналам, относительная фаза между полосами от неё не меняется, а значит и сведение кроссоверов не разваливается.
В общем, если есть конкретный технический косяк в алгоритме — мне действительно интересно его обсудить.
dimosus
Для контроля ушами в программе как раз есть аудирование: можно прогнать любой трек через измеренную систему со всей текущей обработкой и послушать результат. Центр сцены у меня, например, в наушниках получается там же, где потом и в машине.
А вот человек на водительском во время измерений, на мой взгляд, скорее мешает. Он сам становится частью акустической системы: голова, плечи, положение тела вносят отражения и поглощение, причём плохо воспроизводимые от замера к замеру. Мне нужна повторяемая характеристика самой системы в фиксированной точке. А влияние головы и ушей уже происходит тогда, когда человек эту систему слушает.
Против вашего энтузиазма я ничего плохого не имею. Не подумайте. Ради бога. Просто все эти подстройки эквализации под целевую — абсолютное зло. Особенно в системах с высоким разрешением, где лишние под дБ в плюс или минус на какой то частоте, могут ушатать общее восприятие. Да, че то как то настроится. Будут крутые графики. Все будет потрясающее сведено на экране. Но не факт что это будет петь.
Абсолютное зло, ха. Вообще-то при настройке аудиосистемы именно эквализацией добиваются желаемой целевой кривой, их даже есть целый набор. Лично я использую ATF (теперь она называется ATF Daily), и именно с ней моя жена на днях стала чемпионом Германии, а я сам этой весной — чемпионом Европы. А судьи на соревнованиях слушают машины, а не смотрят графики на экране.
Поздравляю. Но от того что вам дали медаль, мое мнение поменяется едва ли. Строгая подгонка под целевую и погоня за красивым графиком — зло.
> Особенно в системах с высоким разрешением, где лишние под дБ в плюс или минус на какой то частоте, могут ушатать общее восприятие.
На чем основывается это утверждение? Приведите ссылки на качественные исследования.
Что именно считается эталоном от которого нельзя отступать на +-0.5дБ в данном утверждении? АЧХ динамика отдельно взятого? АЧХ источника звука? От чего отсчитывать 0.5?
Что насчет того, что окружение(материалы, объем, расположение, монтаж) может менять дБ на ДЕСЯТКИ единиц? Это мы игнорируем? Характеристики динамика замеренного в infinite baffle или вообще симулированного в CAD не имеют ничего общего с тем как он будет играть в окружении в которое его установят. Вклад окружения в финальное звучание больше чем всё остальное. Иначе работает только в безэховой камере.
Первостепенная задача эквализации КОМПЕНСИРОВАТЬ ВЛИЯНИЕ ОКРУЖЕНИЯ и индивидуальных особенностей устройства, а не сделать музыку другой.
Это дома вы можете выделить отдельное помещение, повесить шторы в несколько десятков килограмм, обмазаться звукоизоляцией, подавителями эха и бас-ловушками. Переставлять мебель и т.д.
В авто у вас из возможностей только эквалайзер, виброизоляция и антискрип.
Чтобы все стилистические задумки продюсера и работа звукоинженера, который сводил аудиозапись, были воспроизведены так, как задумывалось, — без «нюансов», добавленных вашей системой, — она должна повторять характеристики аудиосистемы, на которую они целились.
Нормальные студии в рамках мастеринга проводят прослушивание не только на эталонных мониторных динамиках, но и, например, на дешевых наушниках по типу AirPods или воспроизводят трек на BT-колонках. Стоит ли говорить, что большинство потребительской техники имеет или Harman-кривую, или JBL.
Базовый домашний Hi-Fi в абсолютном большинстве случаев тоже уходит или в V-shape, или в Harman. Крутые HiEnd HiRez системы как раз таки тоже эквализируют под помещение. Всякие Dirac и системы FIR фильтрами не просто так существуют
Эквалайзер это аналог калибровки монитора или принтера в типографии. Каждая уникальная единица оборудования ведет себя уникально их НУЖНО приводить к целевому состоянию. Для аудиосистем это выбранная таргет-кривая.
Если продюсер сводил под наушники с Harman-кривой, и в машине вы добились хоть немного попадания в Harman-кривую, то очевидно вы получите хоть какое-то совпадение.
Если вам не нравится Harman и вы хотите навалить собственного стиля, вы можете выбрать другую таргет-кривую. Потеря уровня сигнала на каких-то частотах из-за выбранной кривой уже ваша ответственность и осознанный выбор. Самое главное что он у вас есть, в отличие от систем без EQ.
Для понимания влияния уровня эквалайзера в системах с высоким разрешением нужны исследования?) Проведите.
Очевидно нужны и не влияния эквалайзера, а влияние +-0.5дБ (не известно от чего эти 0.5 потому что ты не в состоянии ответить) Если речь о линейности АЧХ(остается только догадываться), то очень интересно почитать про 0.5дБ особенно учитывая, что на разных частотах чувствительность слуха разная. И что там про влияние окружения и линейность АЧХ? Ответ то будет?
blk104
Абсолютное зло, ха. Вообще-то при настройке аудиосистемы именно эквализацией добиваются желаемой целевой кривой, их даже есть целый набор. Лично я использую ATF (теперь она называется ATF Daily), и именно с ней моя жена на днях стала чемпионом Германии, а я сам этой весной — чемпионом Европы. А судьи на соревнованиях слушают машины, а не смотрят графики на экране.
Позвольте полюбоваться. Формулировка «стала чемпионом Германии», подразумевая под собой то, что она сама собрала систему, потом ее настроила, удачным образом презентовала судьям, и победила?
Правилами соревнований не запрещается полностью сделать машину в студии автозвука, а затем презентовать на соревнованиях и победить. В данном случае в роли студии был я.
dimosus
Для контроля ушами в программе как раз есть аудирование: можно прогнать любой трек через измеренную систему со всей текущей обработкой и послушать результат. Центр сцены у меня, например, в наушниках получается там же, где потом и в машине.
А вот человек на водительском во время измерений, на мой взгляд, скорее мешает. Он сам становится частью акустической системы: голова, плечи, положение тела вносят отражения и поглощение, причём плохо воспроизводимые от замера к замеру. Мне нужна повторяемая характеристика самой системы в фиксированной точке. А влияние головы и ушей уже происходит тогда, когда человек эту систему слушает.
Еще искренне надеюсь что эти цифры на примере в мануале по кроссоверам, ничего общего с реальностью не имеют, и никому такую дичь предлагать не будет ваше приложение.
BugsBunny763
Я о всем методе в целом. Отсутствие контроля процесса ушами приведет к бестолковой трате времени за ноутбуком. Про замеры без человека на водительском сиденье я вообще молчу.
> Отсутствие контроля процесса ушами приведет к бестолковой трате времени за ноутбуком
Контроль ушами — субъективная метрика
Контроль измерительными инструментами — объективная
Шанс того что человек окажется глухим, тупицей или просто мошенником которому вы отдали деньги за настройку сиииииииильно выше чем ошибка при сложении циферок процессором ноутбука.
Вы мне можете не рассказывать. Я эти все этапы на своей шкуре прошел.
sewergun
> Отсутствие контроля процесса ушами приведет к бестолковой трате времени за ноутбуком
Контроль ушами — субъективная метрика
Контроль измерительными инструментами — объективная
Шанс того что человек окажется глухим, тупицей или просто мошенником которому вы отдали деньги за настройку сиииииииильно выше чем ошибка при сложении циферок процессором ноутбука.
Я всего лишь своими комментариями предостерегаю людей которые первый раз ачх в глаза увидят, от слепого доверия этим самым циферкам и волшебным программам.